El hardware de inteligencia artificial avanza en varios frentes a la vez, y esta semana tres movimientos permiten leer hacia dónde se orienta la industria. Nvidia presentó un modelo de IA que enseña a robots a ejecutar tareas observando vídeos de personas, según recoge Infobae. Intel dio a conocer la GPU D270 para supercomputación, con 32 núcleos Xe y 160 GB de memoria, según Pisapapeles. Y el proveedor cloud Lambda está usando conmutadores de óptica co-packaged de NVIDIA Photonics para conectar racks GB300 NVL72 con más de 10.000 GPUs, según el blog de la compañía. Son piezas distintas de un mismo rompecabezas: cómo se entrena, cómo se conecta y cómo se aplica la inteligencia artificial sobre hardware físico.
Robots que aprenden mirando vídeos

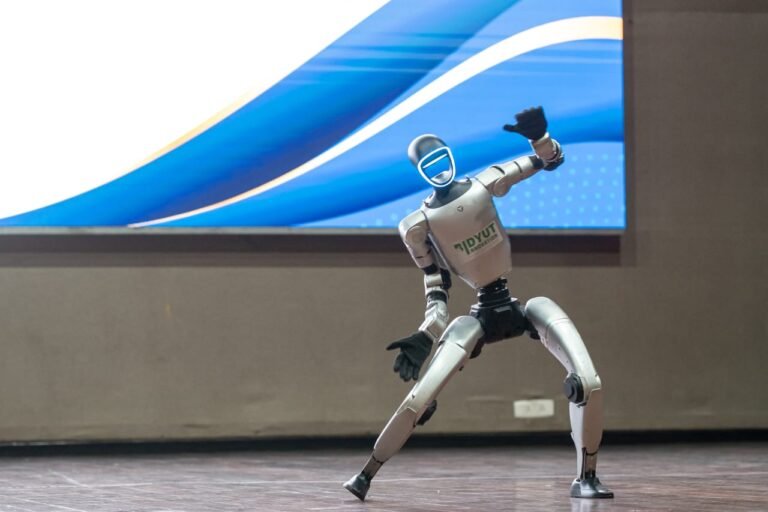
El anuncio de Nvidia sobre el entrenamiento de robots a partir de vídeos de personas apunta a un problema clásico de la robótica: la dificultad de trasladar habilidades humanas a una máquina. Tradicionalmente, programar un robot para una tarea concreta exige definir movimientos, sensores y condiciones de forma explícita. El enfoque que describe Infobae sugiere que el modelo aprende observando, es decir, extrayendo patrones de comportamiento de grabaciones de personas reales. La información disponible no detalla la arquitectura del modelo, el conjunto de datos empleado ni las condiciones en las que se evaluó, por lo que conviene tratar el anuncio como una presentación de capacidades y no como un despliegue comercial verificado. En paralelo, Intel presentó la GPU D270, una pieza orientada a supercomputación con 32 núcleos Xe y 160 GB de memoria, según Pisapapeles. La cifra de memoria es relevante en un contexto donde los modelos de IA crecen y necesitan aceleradores capaces de sostener cargas de trabajo intensivas. La nota no especifica precios, disponibilidad ni comparativas de rendimiento frente a otras soluciones, de modo que su impacto real dependerá de cómo se integre en sistemas existentes. El tercer frente llega desde el blog de NVIDIA: Lambda, un proveedor de servicios cloud, utiliza conmutadores de óptica co-packaged de NVIDIA Photonics para conectar racks GB300 NVL72 con más de 10.000 GPUs. La fotónica co-packaged integra componentes ópticos junto a los chips para mejorar la transmisión de datos entre aceleradores. En entrenamiento de modelos, la red que une miles de GPUs puede convertirse en cuello de botella, y de ahí el interés por soluciones que reduzcan latencia y aumenten la resiliencia del conjunto.
Leído en conjunto, los tres anuncios describen una cadena: el modelo que aprende de vídeos necesita datos y cómputo, el cómputo se apoya en aceleradores como la GPU D270 de Intel o las GPUs de Nvidia, y esos aceleradores deben comunicarse entre sí mediante redes fotónicas como las que describe Lambda. La consecuencia práctica es que la competencia en hardware de inteligencia artificial ya no se libra solo en el número de núcleos o en la memoria de una tarjeta, sino en la capacidad de sostener sistemas completos. Para el sector de la robótica, un modelo que aprende observando vídeos podría reducir el coste de programar tareas nuevas, aunque la distancia entre una demostración y un robot operando en un almacén o una fábrica sigue siendo considerable. Para Intel, la D270 representa un intento de mantener presencia en un segmento donde Nvidia ocupa una posición dominante; la falta de datos públicos sobre rendimiento impide valorar su alcance. Para los proveedores cloud como Lambda, la adopción de fotónica co-packaged sugiere que la eficiencia energética y la resiliencia de la red se han convertido en prioridades tan relevantes como la potencia bruta de cálculo. En el trasfondo aparece CUDA, la plataforma de Nvidia que cumple 20 años y que el blog de la compañía reivindica como base del cómputo científico y de la IA moderna. Esa longevidad explica parte de la ventaja de Nvidia: no es solo hardware, es un ecosistema de desarrollo con dos décadas de recorrido. Cualquier competidor que aspire a disputar ese terreno debe ofrecer no solo chips, sino herramientas y comunidad. La pregunta abierta es si el resto de la industria puede construir una alternativa comparable o si el mercado seguirá organizándose alrededor de la plataforma dominante.
Intel y la presión en supercomputación
Queda por ver cómo evoluciona el modelo de Nvidia para robots: si se publican detalles técnicos, si se prueba en entornos reales y si otros laboratorios replican el enfoque. En el caso de Intel, la GPU D270 necesita datos de rendimiento independientes y una hoja de ruta clara de disponibilidad para medir su peso real en supercomputación. La apuesta de Lambda por la fotónica co-packaged será observada por otros operadores cloud: si mejora la eficiencia de los clústeres de entrenamiento, es probable que se extienda. También conviene seguir la conversación sobre entrenar IA con GPUs domésticas, que plantea límites prácticos frente a las infraestructuras de miles de aceleradores. Y, de fondo, el vigésimo aniversario de CUDA recuerda que la ventaja competitiva en este sector se construye durante años, no en un solo anuncio. Fuentes consultadas: Infobae, NVIDIA Blog, Pisapapeles y Pasquale Pillitteri.
Mesa editorial: Infra Pulse
Fuentes consultadas
- Fuente consultada (Google News Hardware IA)
- Fuente consultada (NVIDIA Blog)
- Fuente consultada (Google News Hardware IA)
- Fuente consultada (Google News Hardware IA)
- Fuente consultada (NVIDIA Blog)